


Page 71 - 《爆炸与冲击》2026年第11期
P. 71
第 46 卷         王帅帅,等: 数据驱动的箍筋加密钢筋混凝土柱爆炸损伤预测与评估模型                               第 11 期

                                                            n
                                                           ∑        2
                                                              (y i − ˆy i )
                                                     2      i=1
                                                    R = 1−  n                                          (12)
                                                           ∑ (
                                                                   ) 2
                                                               y i −y i
                                                           i=1
                                                            n
                                                           ∑
                                                              |y i − ˆy i |
                                                     e MAE =  i=1                                      (13)
                                                               n
                                                          Õ
                                                             n
                                                            ∑
                                                               (y i − ˆy i ) 2
                                                   e RMSE =  i=1                                       (14)
                                                                n
                                           e MedAE (y, ˆy) = median(|y 1 − ˆy 1 |,··· ,|y n − ˆy n |)  (15)
                                                                                             2
                           y   分别为真实值、预测值和真实值的平均值,n                  为数据集中的样本总数。R 衡量模型与数
               式中:   y i  、    ˆ y i  和    i
               据的拟合程度,表示模型对可变性的解释程度。e                     MA E  计算预测值与真实值之间的平均绝对偏差,能够客
               观反映模型预测误差的总体水平。e                   E  计算预测值与真实值之间的均方根误差,其数值与原始数据在
                                               RMS
               同一量纲,使得误差解释更直观。e               MedA E  计算预测值与真实值的绝对误差的中位数,提供了一个对异常
               值不敏感、更稳健的指标,更好地反映了模型对大多数样本的预测能力。R 越趋近于                                       1,表明模型对数
                                                                                  2
               据变异性的解释程度越高,模型拟合度及预测可靠性也随之提升。相反,e                                  、e   E  和  e  E  作为误差度
                                                                                MAE  RMS    MedA
               量指标,其值越逼近         0,表明预测结果与实测数据之间的残差越小,表征模型具备更高的预测精度。
                3.2.2    机器学习模型优化超参数的过程
                   在构建机器学习损伤预测模型时,超参数的配置对模型性能具有决定性影响。鉴于此,采用                                          Akiba
               等 [48]  提出的  Optuna  自动优化框架进行超参数寻优。该框架的核心优势在于引入了树结构                                Parzen  估
               计器(tree-structured Parzen estimator, TPE)作为采样算法。相较于传统的网格搜索或随机搜索,TPE                       能
               够基于历史评估结果构建概率模型,从而自适应地向高潜力的参数区域收敛,显著提升了搜索效率与
               优化质量。
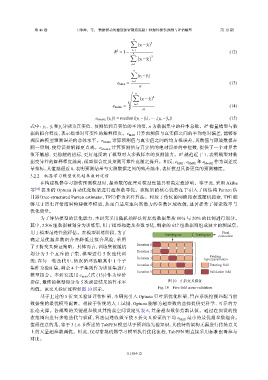
                   为了评估模型的泛化能力,本研究采用随机抽样法将原始数据集按                                80%  与  20%  的比例进行划分。
               其中,2 506  组数据被划分为训练集,用于模型构建及参数寻优,剩余的                          627  组数据则组成独立的测试集,

                                                                                                    Final
               用于模型最终性能评估。在模型训练阶段,为了                                      Training set  Testing set  evaluation
               确定最优超参数组合并降低过拟合风险,采用
                                                              Iteration 1
               了  5  折交叉验证策略。具体而言,训练集被随机
                                                              Iteration 2
               划分为    5  个互斥的子集,模型进行           5  次迭代训
                                                                                              Finding
                                                              Iteration 3                  hyperparameters
               练;在每一轮迭代中,依次循环选取其中                  1  个子
                                                              Iteration 4                     Training fold
               集作为验证集,剩余         4  个子集则作为训练集进行
                                                              Iteration 5                     Validation fold
               模型拟合。本研究选用           e  MAE (式  (13))作为评价
               指标,最终的模型得分为           5  次验证结果的算术平                           图 10    5  折交叉验证
               均值。该交叉验证流程如图             10  所示。                        Fig. 10    Five-fold cross-validation
                   基于上述的      5  折交叉验证评估框架,本研究引入               Optuna 贝叶斯优化框架,旨在系统挖掘匹配当前
               数据集的最优模型配置。相较于传统的人工试错,Optuna 能够为超参数的选择提供更科学、可靠的方
               法论支撑。各模型的关键超参数及其搜索空间设定见表                           6,其余超参数保持默认值。通过在预设的搜
               索范围内进行多轮迭代与验证,算法最终收敛至使                        5  折交叉验证的平均        e  MA E  最小的最优超参数组合。
               值得注意的是,鉴于         3.1.6  节所述的  TabPFN  模型基于预训练先验知识,其独特的架构无需进行传统意义
               上的大量超参数调优。因此,仅对常规机器学习模型执行优化流程,TabPFN                                则直接采用标准配置参与
               对比。


                                                         111504-12

