


Page 47 - 《爆炸与冲击》2026年第11期
P. 47
第 46 卷        潘美霖,等: 基于贝叶斯深度主动学习的三维城市建筑群爆炸载荷快速预测                               第 11 期

               失值填充,提取各位置超压峰值,构建反映建筑群区域压力场空间分布的离散数据集,为后续场分布预
               测建模提供支持。
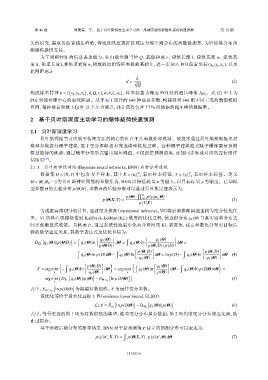
                   为了增强特征的信息表达能力,在由能量源当量                       Q、起爆距离      r、建筑长度     l、建筑宽度     w、建筑高
               度  h、街道长度    l s  和街道宽度   w s  构成的原始特征参数的基础上,进一步加入                POI 位置坐标     (x p ,y p ,z p  ),以及
                       d  :
               比例距离
                                                             L
                                                         d = √                                          (2)
                                                             3
                                                              Q
                               (
                                       )
                            x = [ x p ,y p ,z p ,d,Q,r,l,w,h,l s ,w s ]  ,样本标签为相应  POI 处的超压峰值  Δp 。式  (2) 中  为
               构成样本特征                                                                       0          L
               POI 到能量源中心的直线距离。基于表                1  设计的  648  种场景参数,构建得到         648  组不同工况的数值模拟
               算例,每种场景参数下包含            12  个压力测点,共计获得包含           7 776  组数据的超压峰值数据集。
                2    基于贝叶斯深度主动学习的爆炸载荷快速预测


                2.1    贝叶斯深度学习
                   贝叶斯深度学习区别于传统方法的核心特征在于其参数处理机制。该技术通过贝叶斯推断框架对
               模型参数进行概率建模,基于变分推断技术完成模型优化过程。这种概率建模范式赋予爆炸载荷预测
               模型独特的优势:通过概率分布形式输出超压峰值,不仅提供预测结果,还能同步生成对应的置信度评
               估结果   [29] 。
                2.1.1    贝叶斯神经网络   (Bayesian neural networks, BNN) 后验分布建模
                          D = {X,Y}  中包含                      N                      N   表示样本标签。定义
                   数据集                    N  个样本,其中     X = {x i } i=1   表示样本特征,   Y = {y i } i=1
               Θ = {θ 1 ,θ 2 ,…}  为贝叶斯神经网络的参数集合,BNN         以特征向量      x  为输入,以目标标量       y 为输出。已知模
                                             Θ  的后验分布可以通过贝叶斯定理表示为:
               型参数   Θ  的先验分布    p(Θ)  时,参数
                                                              ∏ N
                                                         p(Θ)·    p(y i |x i ,Θ)
                                               p(Θ|X,Y) =       i=1                                     (3)
                                                               p(Y|X)
                   为规避高维积分的计算,通过变分推断(variational inference, VI)将后验推断问题重构为变分优化任
               务。VI 的核心思路是借助           Kullback-Leibler (KL) 散度的优化过程,使近似分布           q λ (Θ)  与真实后验分布之
               间实现渐进式收敛。具体而言,通过系统性地最小化两分布间的                              KL  散度值,建立参数化分布对目标后
               验的数学逼近关系,其数学表达式及优化目标为:
                                            ï      ò             ï             ò
                                   w                     w
                    [           ]             q λ (Θ)                 q λ (Θ)
                D KL q λ (Θ)||p(Θ|D) =  q λ (Θ)ln   dΘ =   q λ (Θ)ln            dΘ =
                                             p(Θ|D)                p(Θ,D)/p(D)
                                   w                w        ï  p(Θ,D)  ò         w        ï  p(Θ,D)  ò
                                     q λ (Θ)ln p(D)dΘ−  q λ (Θ)ln     dΘ = ln p(D)−  q λ (Θ)ln      dΘ (4)
                                                               q λ (Θ)                       q λ (Θ)
                           ß          ï       ò   ™        ß         ï     ò                      ™
                              w         p(Θ,D)               w         q λ (Θ)   w
                  ∗
                 λ =argmin −    q λ (Θ)ln      dΘ = argmin     q λ (Θ)ln     dΘ−   q λ (Θ)ln p(D|Θ)dΘ =
                         λ              q λ (Θ)          λ             p(Θ)
                           {    [         ]      [        ]}
                                                  ln p(D|Θ)                                             (5)
                     argmin D KL q λ (Θ)||p(Θ) − E Θ∼q λ
                         λ
                         [       ]
                          ln p(D|Θ)               λ ∗  为最佳变分参数。
               式中:   E Θ~q λ       为期望对数似然,
                   该优化等价于最大化证据下界(evidence lower bound, ELBO):
                                                    [       ]      [         ]
                                                     ln p(D|Θ) − D KL q λ (Θ)||p(Θ)                     (6)
                                           L(λ) = E q λ
               式中:等号右边的第         1  项为对数似然的期望,推动变分分布拟合数据;第                     2  项约束变分分布接近先验,防
               止过拟合。
                   基于参数后验分布的推导结果,BNN                对于新观测值      x ′  建立的预测分布可以表述为:
                                                        w
                                                                      ′
                                                                        ′
                                              ′
                                                ′
                                           p(y |x , X,Y) =  p(Θ|X,Y)· p(y |x ,Θ)dΘ                      (7)
                                                         111503-6

