


Page 105 - 《高原气象》2026年第3期
P. 105
3 期                       王彩玲等:基于地形引导注意力的降水降尺度模型研究                                         713
                                                                 值后的最大值和最小值(下同)。其中, (a)和(b)中
                                                                 的灰色虚线表示 BG-TGAN 的均值参考线, (c)和
                                                                (d)中的灰色虚线表示 0% 偏差参考线, 用于对比不
                                                                 同模型在均方根误差、 相关系数及极端降水百分位
                                                                 数偏差方面的差异。采用 RMSE-TGAN 在整体精
                                                                 度上表现更优, 具体体现为较低的 RMSE 和更高的
                                                                 CC。与采用 BG-TGAN 损失函数的模型相比, 其
                                                                                  -1
                                                                 RMSE(4. 06 mm·d )降低了 20%, CC(0. 53)提高
                                                                 了 26%。然而, 在极端降水的模拟上(第 95 和 99 百
                                                                 分位数偏差), 采用 RMSE 损失函数的模型却产生
                                                                 了较大的负偏差, 明显偏离观测值; 相比之下, 采
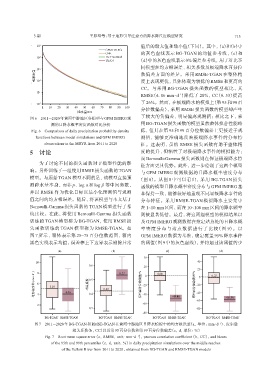
               图6 2011 -2020年黄河中游地区各模型与GPM IMERG观
                        测的日降水概率密度函数对比分析                          用 BG-TGAN 损失函数的模型虽然整体拟合性能略
               Fig. 6 Comparison of daily precipitation probability density   低, 但其在第 95 和 99 百分位数偏差上更接近于观
                 functions between model simulations and GPM IMERG   测值, 能够更准确地反映极端降水事件的分布特
                     observations in the MRYR from 2011 to 2020  征。这表明, 虽然 RMSE 损失函数有助于整体精
               5  讨论                                             度的提升, 但牺牲了对极端降水事件的模拟能力;
                                                                 而 Bernoulli-Gamma 损失函数则在保证极端降水特
                   为了讨论不同的损失函数对于模型性能的影
                                                                 征方面更具优势。此外, 进一步绘制了这两个模型
               响。另外训练了一组使用 RMSE损失函数的 TGAN                        与 GPM IMERG 观测数据的日降水概率密度分布
               模型。与原始 TGAN 模型不同的是, 该模型直接预                       (图 8)。从图 8 中可以看出, 采用 BG-TGAN 损失
               测降水量本身, 而非 p、 log α 和 log β 等中间参数,                函数的模型日降水概率密度分布与 GPM IMERG基
               并以 RMSE 作为优化目标以最小化预测值与观测                          本保持一致, 能够较好地重现不同量级降水事件的
               值之间的均方根误差。随后, 将该模型与本文基于                           分布特征。采用 RMSE-TGAN 模拟降水主要集中
               Bernoulli-Gamma 损失函数的 TGAN 模型进行了系                 在1~10 mm区间, 而在10~100 mm区间的降水频率
               统比较。在此, 将使用 Bernoulli-Gamma 损失函数                  则被显著低估。最后, 将这两组模型的模拟结果以
               训练的 TGAN 模型称为 BG-TGAN, 使用 RMSE 损                  及 GPM IMERG观测数据在指定站点处的日降水概
               失函数训练的 TGAN 模型称为 RMSE-TGAN。如                      率密度分布与站点数据进行了比较(图 9)。以
               图 7 所示, 箱体表示第 25~75 百分位数范围, 箱内                    GPM IMERG 数据为基准, 确定覆盖 95% 降水事件
               黑色实线表示均值, 误差棒上下边界表示剔除异常                           的阈值(图 9 中的灰色虚线), 并将超过该阈值的少


                 图7 2011 -2020年BG-TGAN和RMSE-TGAN在黄河中游地区日降水模拟中的均方根误差(a, 单位: mm·d⁻¹)、 皮尔逊
                                  相关系数(b, CC)以及第95百分位数和第99百分位数偏差(c, d, 单位: %)
                     Fig. 7 Root mean square error (a, RMSE, unit: mm·d⁻¹), pearson correlation coefficient (b, CC), and biases
                        of the 95th and 99th percentiles (c, d, unit: %) in daily precipitation simulations over the middle reaches
                             of the Yellow River from 2011 to 2020, obtained from BG-TGAN and RMSE-TGAN models

