


Page 28 - 《爆炸与冲击》2026年第9期
P. 28
第 46 卷              聂仲恒,等: 基于深度学习算法预测燃爆的临界淬熄直径                                  第 9 期

               氮气体积分数、二氧化碳体积分数、多孔介质厚度及热导率,输出目标为临界淬熄直径。其中,初始压
               力为每次实验开始时管道的初始压力,会对淬熄结果有重大影响;多孔介质厚度和热导率是衡量多孔介
               质淬熄能力的重要参数。为了预测燃气临界淬熄直径,对                           9  个输入特征与输出目标(临界淬熄直径)进
               行最小-最大归一化预处理           [32] ,其数学原理为:

                                                      ¨
                                                      X i =  X i − X min                                (1)
                                                          X max − X min
                    ¨
                    X  为归一化数据,X 为预处理前的数据,X               n  和  X  x  分别为特征数据中的最小值和最大值。该方法
                                    i
               式中:                                      mi    ma
               通过线性变换将各特征压缩至              [0,1] 区间,其核心作用在于消除多量纲特征尺度的差异(如管径与热导率
               的数值量级悬殊),优化梯度下降收敛效率,并提升模型对特征贡献度的均衡学习能力,从而增强预测鲁
               棒性,为深度学习模型构建奠定数据基础                  [33] 。
                1.3    模型介绍
                1.3.1    Transformer 模型
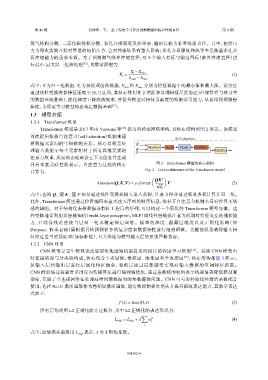
                   Transformer 模型是  2017  年由  Vaswani 等 [34]  提出的神经网络架构,其核心结构如图             2  所示。该模型

               首次提出依赖自注意力(self-attention)机制来建                                  Self-attention
               模数据元素间的全局依赖关系。核心思想是处                          Q
                                                              K
               理输入数据中每个元素相对于所有其他元素的                          V     MatMul  Scale  Mask  SoftMax  MatMul
               注意力权重,从而动态地聚合上下文信息并生成
               具有丰富关联性的表示。自注意力过程的核心                                   图 2    Transformer 模型的核心架构
               计算为:                                               Fig. 2    Core architecture of the Transformer model
                                                                    Å    T  ã
                                                                      QK
                                            Attention(Q, K,V) = softmax  √  V                           (2)
                                                                        d k
               式中:查询    Q、键   K、值  V  向量通过线性变换从输入嵌入获得,注意力得分通过缩放点积计算并归一化。
               此外,Transformer 模型通过位置编码来显式注入序列的顺序信息,弥补了自注意力机制本身对位置不敏
               感的缺陷。对于结构化表格数据或特征工程后的序列,可以构建一个简化的                                   Transformer 模型变体。这
               种变体通常利用多层感知机(multi-layer perceptron,MLP)或线性层模拟注意力机制对特征交互的捕获能
               力  , 并  结  合  残  差  连  接  与  层  归  一  化  来  稳  定  深  层  训  练  。  模  型  的  深  度  、 隐  藏  层  维  度  以  及  正  则  化  策  略  ( 如
               Dropout、权重衰减)需根据具体预测任务的复杂度和数据特性进行细致调整。关键前提是确保输入特
               征经过适当的预处理(如标准化),且其维度与模型输入层的要求严格兼容。
                1.3.2    CNN  模型
                   CNN  模型是受生物视觉皮层层次化感知机制启发而设计的深度学习模型                                 [35] 。标准  CNN  模型由
               特征提取器与分类器构成,核心包含                 3  类层级:卷积层、池化层和全连接层                [36] ,核心架构如图    3  所示。
               从  输  入  层  到  输  出  层  进  行  层  级  化  特  征  抽  象  , 卷  积  层  通  过  局  部  感  受  实  现  对  输  入  数  据  的  空  间  特  征  提  取  。
               CNN  的训练过程通常采用反向传播算法进行端到端优化,通过卷积核的权值共享机制显著降低模型复
               杂度,克服了全连接网络在处理高维图像数据时的参数爆炸问题。CNN                                可与多种非线性激活函数配合
               使用,选择    ReLU  激活函数作为卷积层激活函数,能有效抑制梯度消失并提升稀疏表达能力,其数学表达
               式如下:
                                                      f (x) = max(0, x)                                 (3)
                   所有层均应用       L2  正则化防止过拟合,其中          L2  正则化的表达形式为:
                                                                ∑
                                                    L total = L data +λ  w 2 i                          (4)
                                                                 i
               式中:原始损失函数用          L tota l  表示,λ  为正则化系数。


                                                         091502-4

