


Page 221 - 《高原气象》2026年第5期
P. 221
5 期                   郭继富等:基于BMA降尺度模型的西北雨养农业区干旱监测研究                                        1437
               et al., 2024)。                                    3. 3 帕默尔干旱指数
                   BMA 假设在所有模型中, 每个模型都有一定                            帕默尔干旱指数(Palmer Drought Severity In‐
               的可能性能够很好地描述数据, 而最终的预测结果                           dex, PDSI)作为反映区域干旱严重程度的经典指
               由每个模型的贡献按其后验概率加权。BMA 的核                           标, 其构建过程基于水量平衡原理, 通过量化降水
               心思想是通过对每个模型的后验概率进行加权平                             量(Precipitation)与潜在蒸散量(PET)之间的差异来
               均得到最终的预测结果,即:                                     评估干旱状况(王作亮等, 2019)。本研究以像元为
                                 M                               最小计算单元, 选取 2016 年 6 月、 2017 年 6 月和
                       P( y|X ) = ∑ P( y|M i ,X ) P( M i |D )  (1)
                                i = 1                            2022 年 6 月 3 个典型时段, 采用月尺度时间分辨率
               式中: P( y|M i ,X ) 是模型 M i 在输入的特征因子 X 上            进行计算。PDSI 的核心优势在于其综合考虑了降
               的 SIF 的 500 m 预测值; P( M i |D) 是模型 M i 的后验         水、 蒸发蒸腾及其相对差异的多维度信息(郑健
               概率; M为总模型数。                                       等, 2020), 能够有效捕捉干旱的累积效应和持续
                   模型的后验概率 P( M i |D) 依据贝叶斯定理计                   性特征, 特别适用于农业干旱的监测与预测。通过
                                                                 建立复杂的水分平衡方程和标准化转换公式[式
               算:
                                    P( D|M i P( )               (5)], PDSI不仅能够反映当前水分亏缺程度, 还可
                                           )
                        P( M i |D) =           M i       (2)     以表征干旱的持续时间和发展趋势。本文干旱等
                                   M   (    ) ( )
                                  ∑ P D|M j P M j                效参考国标GB/T 20481-2017划分。
                                   j = 1                                                          P - PET
               式中: P( D|M i) 为模型 M i 对数据 D 的似然函数;                    PDSI = 0.85 × PDSI Pre + 0.15 ×  SD   (5)
               P( M i) 为模型的先验概率。                                 式中: PET 为潜在蒸发蒸腾量; PDSI 为量化降水
                                                                                                   Pre
                   此外, BMA 还能够量化预测的不确定性。通                        量; SD为降水量的标准差。
               过计算不同模型的权重, BMA 能够提供更加稳健                          3. 4 融合BMA降尺度方法
               的预测结果, 并明确不同模型对最终结果的贡献。                               为克服单一模型在预测精度和泛化能力方面
               这种加权平均的方式帮助减少了单一模型对噪声                             的局限性, 本研究采用贝叶斯模型平均法(Bayes‐
               或异常值的敏感性, 增强了预测的稳定性和鲁棒                            ian Model Averaging, BMA)构建多模型集成框架。
               性。因此, 贝叶斯模型平均法优于其他融合方法,                           BMA 作为一种先进的统计集成方法, 通过概率加
               能够综合多个模型的优点, 提升整体预测性能。                            权的方式综合多个模型的预测结果, 有效提升了整
               3. 2 自适应遗传方法                                      体预测性能(Fragoso et al., 2018)。它考虑了每个
                   自适应遗传方法(Adaptive Genetic Algorithm,           模型的不确定性, 并根据模型的历史表现分配权
               AGA)是在传统遗传算法(Genetic Algorithm, GA)               重。BMA 提供了预测的概率分布, 而不仅仅是点
               的基础上, 针对进化过程中的一些缺点提出的改进                           估计并且可以根据新数据动态调整模型权重, 在综
               算法(Gu et al., 2024)。通过自适应调整遗传算法                   合多个模型优势的基础上, 提高预测准确性。本研
               中的关键参数, 以更好地平衡搜索的探索能力和开                           究融合了支持向量机(Support Vector Regression,
               发能力。这种动态调整参数的方法可以提高算法                             SVR)、 随机森林算法(Random Forest, RF)和卷积
               的收敛速度和精度, 适用于优化问题更为复杂的场                           神 经 网 络(Convolutional  Neural  Network,  CNN),
               景(Cheng et al., 2024)。                            利用自适应遗传算法对单个算法进行参数优化, 对
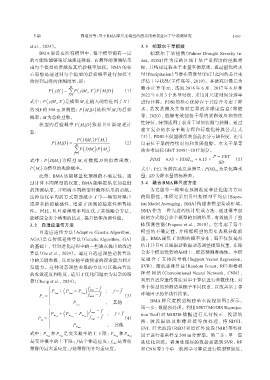
                       ï ïP c min (     )  f max - f  , f < f ˉ  单个模型的预测结果赋予不同权重, 以改善基于多
                       ì
                       ï ï
                   P c = í  + P c max  - P c min  f max - f ˉ  (3)  环境因子的非线性结果。
                       ï ï        P c max        , 其他                BMA 降尺度模型构建基本流程如图 2 所示。
                       ï ï
                       î
                       ï ïP m min (     ) f max - f  , f < f ˉ   第一步: 数据预处理。利用 MRT(MODIS Reprojec‐
                       ì
                                                                 tion Tool)对 MODIS 数据进行几何校正、 投影转
                       ï ï
                  P m = í   + P m max  - P m min  f max - f ˉ  (4)
                       ï ï        P m max         , 其他           换 、 波 段 提 取 及 影 像 拼 接 等 预 处 理 , 将 NDVI、
                       ï ï
                       î
                                                                 EVI、 红光波段(RED)和近红外波段(NIR)等特征
                                                                 因子进行重采样至 500 m 分辨率。第二步: 单一算
                              是交叉概率的上下限; P m max
                                                       和 P m min
                        和 P c min
               式中: P c max
               是变异概率的上下限; f 是个体适应度; f max 是当前                    法优化训练。将预处理好的数据加载到 SVR、 RF
                                 ˉ
               种群的最大适应度; f是种群的平均适应度。                             和 CNN 等 3 个单一机器学习算法进行模型预训练,

