


Page 314 - 《高原气象》2026年第3期
P. 314
高     原      气     象                                 45 卷
              922
             数据集在中国区域的精度优于国际同类陆面模式                              中涉及的地图是基于中华人民共和国自然资源部
             产品(师春香等, 2019; 杨富燕等, 2023), 常被用                    地图技术审查中心标准地图服务系统下载的审图
             作网格化地表温度的“相对真值”, 用于遥感数据的                           号为 GS(2019)3333 号的标准地图制作, 底图无
             交叉检验和数据融合(孙帅等, 2017)。本研究使用                         修改。
             的 CLDAS 地表温度分析产品(以下简称 CLDAS 地                      2. 2 研究方法
             表温度)由国家气象信息中心提供, 选取经过裁切                            2. 2. 1 数据时空匹配
             处理后的 2024 年 5 月 16 日、 6 月 14 日、 9 月 23 日               为确保多源数据在空间上的一致性, 利用 Arc‐
             (以及对应的前一日)08:00 -17:00 的逐小时实时产                     GIS 地理信息系统软件对 CLDAS 地表温度以及其
             品, 空间分辨率为0. 0625°×0. 0625°。                        他辅助数据进行预处理, 包括数据质量控制、 异常
             2. 1. 3 气象站点地面观测数据
                                                                值剔除、 投影转换、 镶嵌和裁剪等操作, 并将所有
                  气象站点地表温度观测数据来源于国家气象
                                                                数据重采样统一到与FY-4B地表温度数据相同的空
             信息中心, 数据涵盖研究区域 98 个国家基本气象
                                                                间分辨率, 以便用于格点检验及模型构建。此外,
             站。选取与典型日期(及前一日)对应的逐小时地
                                                                利用双线性插值方法提取气象站点对应像元位置
             表温度观测数据。所有数据均经过严格的质量控
                                                                的 FY-4B 地表温度、 CLDAS 地表温度以及地表温
             制, 剔除了明显的异常值和缺测记录。
                                                                度融合结果, 用于站点检验及模型效果对比分析。
             2. 1. 4 其他辅助数据
                                                                    为了最大程度保持时间上的同步性, FY-4B 地
                  数字高程模型(Digital Elevation Model, DEM)
                                                                表温度、 CLDAS 地表温度和气象站点地面观测数
             数据来源于 SRTM DEM 数据集, 原始空间分辨率
                                                                据均选取每个数据日期内逐小时整点时刻的数据,
             为 90 m。坡度和坡向数据由 SRTM DEM 数据加工
                                                                以减少时间差异可能引入的误差。对于时间分辨
             生成。MODIS NDVI数据和土地覆盖类型数据来源
                                                                率较低的 NDVI 数据, 则选用距离各典型日期最近
             于 NASA 数据服务网站(https: //ladsweb. modaps.
                                                                的1期产品。
             eosdis. nasa. gov)。其中, NDVI 数据包括 MODIS
                                                                2. 2. 2 XGBoost机器学习算法
             植被指数产品 MOD13A2 和 MYD13A2, 时间分辨
                                                                    XGBoost 是一种高效、 灵活且可扩展的梯度提
             率均为 16 d, 空间分辨率为 1 km; 土地覆盖类型数
             据为 MODIS土地覆盖类型产品 MCD12Q1, 空间分                      升决策树(Gradient Boosting Decision Tree, GBDT)
             辨率为 500 m。此外, 还使用了其他相关数据, 包                        机器学习算法(Chen et al, 2016)。XGBoost 通过迭
             括像元中心的经度、 纬度以及日积时(即当日的第                            代方式构建一系列决策树模型, 每一步优化的目标
             几个小时)等。                                            是最小化损失函数, 并通过二阶梯度信息提升收敛
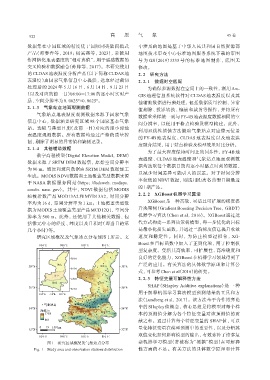
                  研究区域概况及气象站点分布如图 1所示。文                         速度和稳定性。同时, 为防止模型过拟合, XG‐
                                                                Boost 在目标函数中加入了正则化项, 用于控制模
                                                                型复杂度。凭借其高效率、 可扩展性、 高准确度和
                                                                良好的泛化能力, XGBoost在机器学习领域得到了
                                                                广泛的应用。有关算法的具体数学原理和计算公
                                                                式, 可参考Chen et al(2016)的研究。
                                                                2. 2. 3 特征变量可解释性方法
                                                                    SHAP(SHapley Additive  explanations)是 一 种
                                                                用于解释机器学习算法模型预测结果的工具和方
                                                                法(Lundberg et al, 2017)。该方法基于合作博弈论
                                                                中的 SHapley 值概念, 核心思想是将模型对每个样
                                                                本的预测值分解为各个特征变量对该预测值的贡
                                                                献之和。通过计算每个特征变量的 SHAP 值, 可以
                                                                量化特征变量在模型预测中的重要性, 以及分析其
                                                                取值变化如何影响模型的输出, 有效弥补了许多复
                      图1 研究区域概况及气象站点分布                          杂机器学习模型(常被称为“黑箱”模型)在可解释
                Fig. 1 Study area and observation stations distribution  性方面的不足。有关方法的具体数学原理和计算

